“对于每章的实验,不需要看具体代码,理解原理后自己用 coding agent 从头实现这个实验的代码,达到预期的效果。” — #637
1. AI Agent 入门
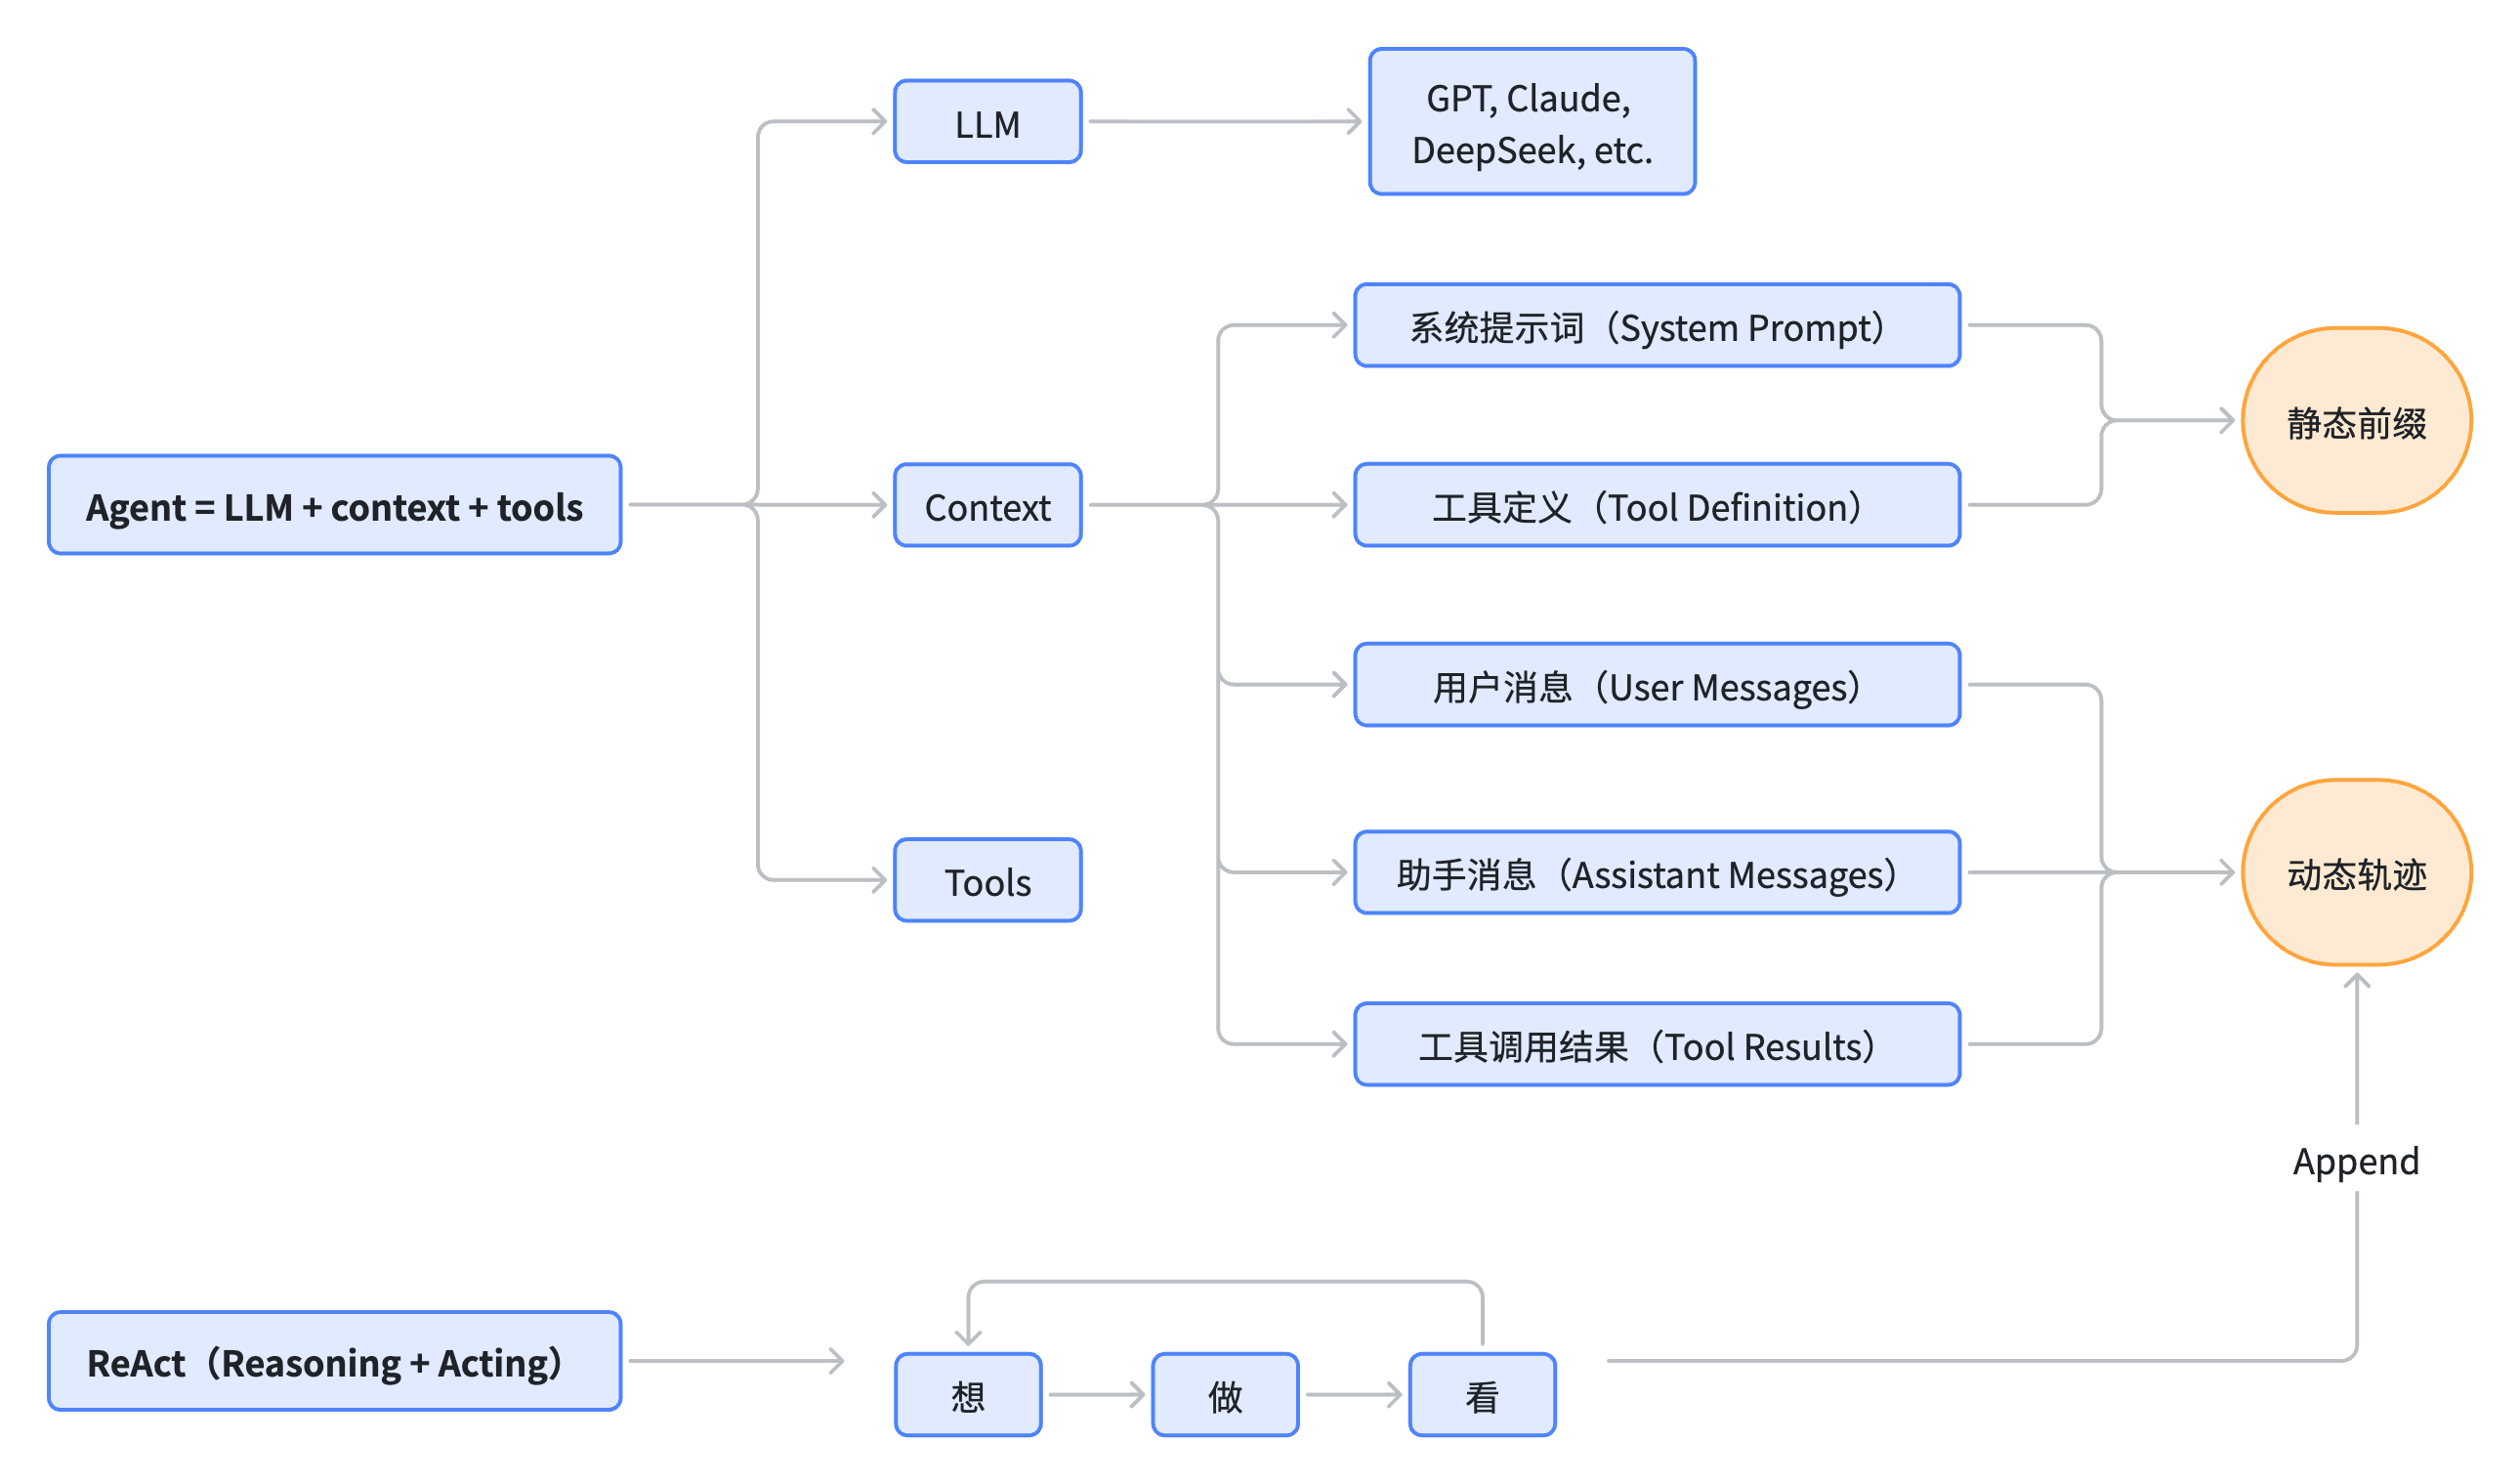
1.1 Agent = LLM + Context + Tools
- LLM 是大脑,负责理解和决策;
- Context 是眼睛,决定模型当前能看到什么;
- Tools 是手脚,让模型能够读取或改变外部世界。
Agent 并不只是一个 LLM。模型本身再强,如果看不到必要的信息,或者没有完成任务所需的工具,也只能停留在回答层面。
Agent 与 Environment 是闭环中的交互双方,而不是同一层的组成部分:环境提供观察,Agent 根据上下文选择行动,行动再改变环境。工具正是这两个方向的接口,既把环境状态带给 Agent,也让 Agent 能够作用于环境。
1.2 Context = 静态前缀 + 动态轨迹
上下文可以分成五个部分:
| 部分 | 作用 | 所属部分 |
|---|---|---|
System Prompt | 规定 Agent 的身份、目标和行为边界 | 静态前缀 |
Tool Definition | 告诉模型有哪些工具、如何调用 | 静态前缀 |
User Messages | 用户提出的任务和补充信息 | 动态轨迹 |
Assistant Messages | 模型此前的回答和工具调用 | 动态轨迹 |
Tool Results | 工具执行后返回的结果 | 动态轨迹 |
前两部分是静态前缀,后三部分组成动态轨迹。所以可以把 Agent 的上下文简单写成:上下文 = 静态前缀 + 动态轨迹。
“上下文”这个词比“提示词”准确得多:它不只是开发者写下的指令,也包括任务已经进行到哪一步、模型做过什么、工具返回了什么。
1.3 ReAct:想、做、看
Agent 的运行方式可以概括成 ReAct(Reasoning + Acting):想 → 做 → 看。模型先判断下一步要做什么,再调用工具行动,最后读取结果;结果被加入动态轨迹,模型根据更新后的上下文继续下一轮。1
上下文 → 想 → 做 → 看 → 追加到动态轨迹 → 下一轮一次最小交互轨迹可以写成:
- 模型:判断当前信息不足,决定查询实时状态;
- 工具:执行查询,并把结果返回给 Agent;
- 观察:工具结果被追加到动态轨迹,成为下一轮上下文的一部分;
- 模型:读取新的观察,决定继续调用工具或生成最终回答。
ReAct 的关键不在于“想”这个词,而在于形成了一个闭环:模型不再一次性给出答案,而是根据外部反馈逐步推进任务。
2. 上下文工程
2.1 上下文质量是 Agent 成功的关键
上下文的质量,往往比上下文的长度更重要。模型再强,如果拿到的信息缺失、混乱,或者放在了不合适的位置,Agent 也很难稳定完成任务。
2.2 Messages:一次请求里的完整上下文
调用 LLM 时,通常需要把上下文放进标准的 messages 数组中。它本质上是 JSON,每条消息带有一个 role:
[
  { "role": "system", "content": "规则和背景" },
  { "role": "user", "content": "用户的问题" },
  { "role": "assistant", "content": "模型此前的回答或工具调用" },
  { "role": "tool", "content": "工具返回的结果" }
]在常见的消息协议中,system 的优先级最高,user 是用户消息,assistant 是助手消息,tool 是工具结果;具体优先级仍以所用 API 和模型的规范为准。
一次 LLM 调用在语义上是无状态的。除非框架或服务端额外保存了会话,否则模型不会自动记得上一轮发生过什么,调用方必须在 messages 中重新提供需要的上下文。
system prompt 和工具定义构成相对稳定的静态前缀;用户、助手和工具消息则组成随交互增长的动态轨迹。
2.3 KV cache:尽量保持前缀稳定
在推理过程中,模型会为已经处理过的 token 计算并保存 Key/Value,这就是 KV cache。下一步生成时可以复用这些结果,避免从头计算。
因此,上下文工程有三个简单原则:
system prompt和tool definition在同一任务或版本中尽量保持不变;- 动态消息只追加在末尾,不要每轮改写前面的前缀;
- 使用 API 原生的消息结构,不要把 JSON 自己拼成一大段文本。
稳定前缀主要带来计算和延迟上的收益;是否减少计费 token,还要看具体服务是否提供 prompt caching 以及它的计费规则。
2.4 位置偏好
模型对上下文不同位置的利用并不完全均匀。长上下文任务中,重要信息放在开头或结尾,通常比放在中间更容易被利用,这就是常说的“Lost in the Middle”现象。2
所以,稳定的规则适合放在前面,当前任务状态和本轮最重要的约束可以放在靠近生成位置的地方。但这只是布局经验,不是所有模型都严格遵守的规则,仍然需要用真实任务测试。
2.5 JSON 如何进入模型
开发者看到的是结构化 JSON,模型实际接收的却是 token 序列。消息会先经过模型对应的 chat template,被线性化成带有角色标记和特殊 token 的文本,再交给 Transformer 处理。不同模型的模板可能不同,因此不应该假设所有模型都能理解同一种手写格式。3
2.6 KV cache 和 prompt cache
这两个概念容易混在一起:
- KV cache:通常指一次推理过程中保存的中间 Key/Value,主要解决重复计算问题;
- prompt cache:指多次 API 请求之间复用相同的提示词前缀,服务商往往通过复用已经计算好的表示来降低延迟和输入成本。
可以把 prompt cache 理解成更上层的跨请求缓存,但它不是协议层的必然能力,是否启用、如何匹配和如何计费,都由具体服务决定。4
2.7 Prompt Engineering 的六个抓手
我把提示词设计暂时归纳成六点:
- 语气和强调:明确语气、受众和输出风格;少量标题、符号或大写可以制造显著性,但不是越多越有效。
- 结构化提示:用 Markdown 表示层级,用 XML 或其他明确分隔符区分指令、数据和示例。
- 流程驱动:把任务写成可执行的流程,例如“读取 → 判断 → 操作 → 验证”。
- 细化业务规则:把模糊要求改成条件、优先级、例外和决策边界。
- 提供示例:对于难以用文字描述的抽象规则,给出高质量的输入—输出示例通常更直接。
- 设计工具定义:工具描述要清楚,但不必一次把所有细节塞进上下文,可以采用渐进式披露。
渐进式披露的核心是:先让 Agent 知道“有哪些能力、什么时候使用”,真正需要时再加载完整说明。动态提示词和 Agent Skills 都可以采用这种方式。
以 SKILL.md 为例,常见做法是用 YAML front matter 写入 name 和 description,启动时只把这些元信息放进 system prompt;匹配到某个 skill 后,再读取完整文档和附属资源。这样既减少常驻上下文,也让能力可以按需扩展。具体字段和加载时机取决于实现,并不是所有 Agent 都共享同一种协议。5
2.8 Agent Status Bar
状态栏可以看成一段由代码维护的元信息,用来帮助 Agent 管理轨迹。它可以包含任务规划、事件的侧信道信息和环境当前状态。
状态栏适合插入在最新一轮消息之后、模型生成之前,以获得较高的近期注意力。它不应该让 LLM 自己维护:关键状态要由程序根据真实数据生成,原始数据也不能为了变短而删除。状态栏一旦不准确,后续决策就会建立在错误的轨迹上。
2.9 上下文压缩
状态栏适合用代码生成;历史上下文的压缩则常常需要 LLM 做摘要或蒸馏,尤其是对冗长的工具结果进行提炼。压缩会改变被压缩位置之后的内容,因此那一段之后的 KV cache 通常需要重新计算。
压缩的目标,是把“需要重新思考才能得到的结论”变成可以直接检索的知识。设计时需要注意四点:信息价值并不均匀、摘要要保持语义完整、内容要围绕当前任务筛选,以及压缩本身就是一种理解,需要单独评估。
关键的决策、计划变更和回滚记录不应被压缩。很多时候,隔离比压缩更安全:例如让子 Agent 在独立上下文中工作,主 Agent 只接收经过整理的结果。
Footnotes
-
Yao et al., “ReAct: Synergizing Reasoning and Acting in Language Models”, 2022. https://arxiv.org/abs/2210.03629 ↩
-
Liu et al., “Lost in the Middle: How Language Models Use Long Contexts”, 2023. https://arxiv.org/abs/2307.03172 ↩
-
Hugging Face, “Chat templates”, https://huggingface.co/docs/transformers/en/chat_templating ↩
-
OpenAI, “Prompt Caching in the API”, https://openai.com/index/api-prompt-caching/ ↩
-
Anthropic, “Equipping agents for the real world with Agent Skills”, https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills ↩